
چگونه مدیریت فایل ها را با هوش مصنوعی خودکار کنیم؟
پوشهای را تصور کنید که هر روز چند فایل تازه به آن اضافه میشود؛ گزارشهای PDF، متنهای ارسالی همکاران و تصاویر اسکنشدهای که نام مشخصی ندارند. برای پیدا کردن موضوع هر فایل باید آن را باز کنید، چند صفحه بخوانید، نامش را تغییر دهید و در پوشه مناسب بگذارید. وقتی تعداد فایلها بیشتر میشود، همین کار ساده بخشی از زمان روزانه را میگیرد و احتمال گمشدن اطلاعات را بالا میبرد.
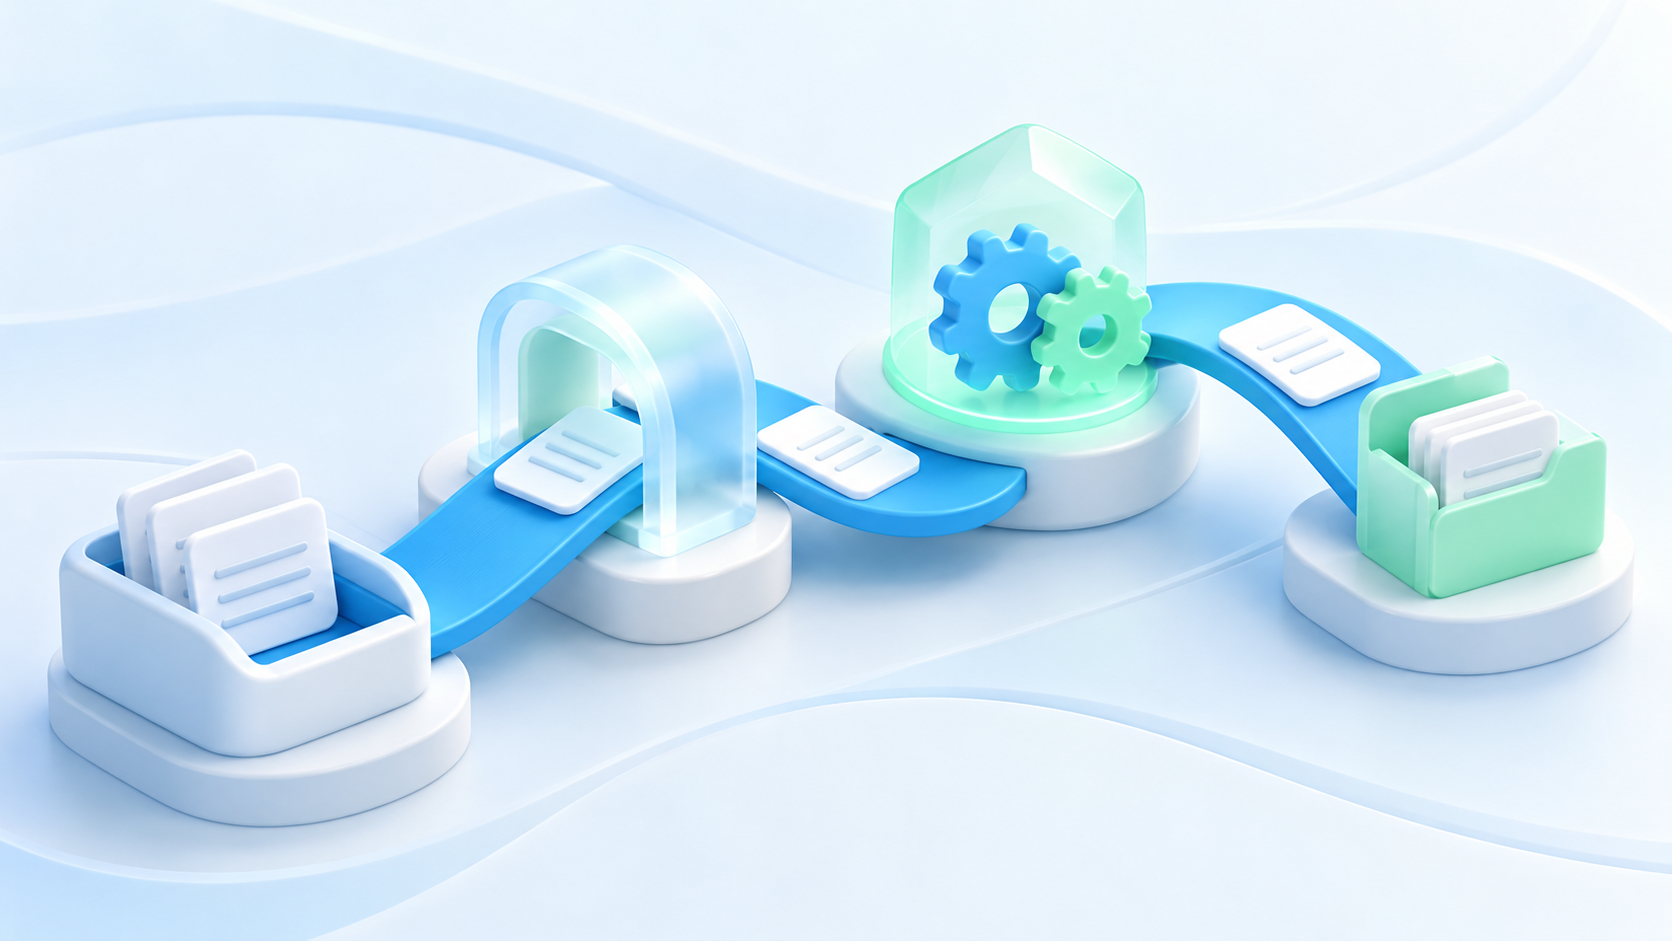
ترکیب هوش مصنوعی با ابزارهای خودکارسازی میتواند این مسیر را کوتاهتر کند. فایل دریافت میشود، محتوای قابل خواندن آن استخراج میشود و یک مدل زبانی برایش موضوع، برچسب و خلاصه پیشنهاد میدهد. نتیجه نیز در محل مشخصی ثبت میشود تا بعدا بتوان آن را پیدا کرد. برای ساخت چنین سیستمی باید بدانیم هر بخش چه کاری انجام میدهد و کدام تصمیمها همچنان به بازبینی انسان نیاز دارند.
پیش از انتخاب ابزار، خروجی را مشخص کنید
شروع کار با انتخاب مدل هوش مصنوعی وسوسهکننده است، اما ابتدا باید مساله را کوچک و روشن تعریف کرد. آیا پیدا کردن فایلها دشوار است؟ آیا همکاران نامگذاری یکسانی ندارند؟ یا برای تشخیص موضوع هر گزارش زمان زیادی صرف میشود؟ پاسخ این سوالها تعیین میکند سیستم قرار است چه خروجیای تولید کند و کدام بخش از کار ارزش خودکارشدن دارد.
برای نمونه، یک تیم تولید محتوا میتواند هدف اولیه را ثبت عنوان، موضوع، خلاصه و نشانی فایل قرار دهد. چنین خروجیای به اعضای تیم کمک میکند بدون بازکردن همه اسناد، فایل مرتبط را پیدا کنند. در این مرحله نیازی به ساخت موتور جستوجوی پیچیده یا پردازش تمام آرشیو نیست. یک مجموعه محدود از فایلهای تازه برای بررسی کیفیت نتیجه کافی است.
همچنین باید دستهها از ابتدا تعریف شوند. اگر یک نفر «آموزش» و دیگری «راهنما» را برای محتوای مشابه انتخاب کند، آرشیو همچنان پراکنده میماند. فهرستی کوتاه از دستههای قابل فهم، همراه با توضیح و نمونه، مبنای مناسبی برای تصمیمگیری مدل و بازبینی همکاران خواهد بود.
میزبانی، پردازش و خودکارسازی چه تفاوتی دارند؟
این سیستم سه نقش جداگانه دارد. برنامه دریافت فایل، ورودی کاربر و وضعیت درخواست را مدیریت میکند. سرویس هوش مصنوعی متن آمادهشده را تحلیل میکند. ابزار خودکارسازی نیز ترتیب اجرای مراحل و انتقال اطلاعات میان آنها را بر عهده میگیرد. محل نگهداری فایلها هم باید مشخص باشد تا اصل سند پس از پایان پردازش در دسترس بماند.
اگر کسبوکار به پنل اختصاصی برای ورود کاربران، دریافت فایل و نمایش نتیجه نیاز داشته باشد، برنامه آن به محیط میزبانی مناسب نیاز دارد. هاست اختصاصی لیارا یکی از گزینههای قابل بررسی برای میزبانی چنین برنامهای است؛ منابع پردازشی، حافظه و فضای ذخیرهسازی پلن باید با نیاز برنامه سنجیده شوند. انتخاب منابع به تعداد درخواستهای همزمان و شیوه پردازش فایلها بستگی دارد.
برای نمونه اولیه، میتوان از یک فرم آماده استفاده کرد و ساخت پنل را به زمانی موکول کرد که نیاز واقعی آن روشن شود. اجرای مدل از طریق API نیز به معنای نصب مدل روی هاست برنامه نیست. درخواست به سرویس مدل فرستاده میشود و پاسخ به جریان کار برمیگردد؛ بنابراین خرید زیرساخت اضافی باید دلیل مشخصی داشته باشد.
مرحله اول؛ فایل را همراه با اطلاعات لازم دریافت کنید
ورودی مناسب، بخش زیادی از ابهامهای مراحل بعدی را کم میکند. کنار دکمه بارگذاری فایل میتوان چند فیلد ساده مانند نام پروژه، نوع درخواست و توضیح کوتاه قرار داد. دانستن اینکه یک گزارش برای کدام پروژه ارسال شده، گاهی از تحلیل دوباره تمام متن کاربردیتر است. این اطلاعات باید کنار فایل ذخیره شوند و در طول فرایند حفظ شوند.
از همان ابتدا قالبهای پذیرفتهشده و محدودیت حجم را مشخص کنید. برای نسخه اولیه میتوان فقط PDF متنی و فایل متنی را پذیرفت. اضافهکردن تصویر، فایل صوتی یا سندهای پیچیده، مسیرهای پردازش متفاوتی میخواهد و بهتر است پس از ارزیابی مرحله اول انجام شود. کاربر هم باید پیش از ارسال بداند چه فایلهایی پذیرفته میشوند.
پس از دریافت، یک شناسه برای فایل بسازید و وضعیت آن را «دریافتشده» ثبت کنید. نام اصلی فایل را نگه دارید، حتی اگر سیستم عنوان بهتری پیشنهاد میدهد. این شناسه کمک میکند نتیجه تحلیل، خطاهای احتمالی و اصلاحات بعدی به همان ورودی وصل بمانند. نمایش وضعیت پردازش نیز از ارسال دوباره فایل توسط کاربر جلوگیری میکند.
مرحله دوم؛ متن قابل استفاده را استخراج کنید
مدل زبانی برای خلاصهکردن سند به محتوای قابل پردازش نیاز دارد. در فایل متنی، دسترسی به این محتوا سادهتر است؛ اما PDF میتواند شامل متن انتخابپذیر، تصویر صفحات یا ترکیبی از این دو باشد. به همین دلیل نباید همه فایلهای PDF را با یک فرض مشترک پردازش کرد. ابتدا باید معلوم شود چه چیزی از فایل استخراج شده است.
در n8n، گره Extract From File امکان استخراج داده از قالبهایی مانند PDF، متن و CSV را فراهم میکند. با این حال، استخراج متن از PDF را نباید معادل خواندن خودکار هر تصویر اسکنشده دانست. سند اسکنشده ممکن است به ابزار تشخیص نویسه یا OCR نیاز داشته باشد. استفاده از مدل بینایی نیز به قابلیت مدل انتخابی و مسیر اتصال آن بستگی دارد.
کیفیت متن استخراجشده را پیش از ارسال بررسی کنید. متن خالی، جابهجایی ستونها، تکرار سربرگها یا بههمریختگی واژههای فارسی میتواند خلاصه نهایی را خراب کند. برای سند بلند نیز متن را به بخشهای معنادار تقسیم کنید و ارتباط بخشها را نگه دارید. بریدن تصادفی متن در میانه جدول یا بند، احتمال برداشت ناقص را افزایش میدهد.
مرحله سوم؛ تحلیل مشخصی از هوش مصنوعی بخواهید
پس از آمادهشدن متن، باید معلوم باشد مدل دقیقا چه کاری انجام میدهد. درخواست کلی «این فایل را بررسی کن» خروجیهای متفاوتی تولید میکند و استفاده خودکار از آنها دشوار است. درخواست مشخص میتواند شامل پیشنهاد عنوان، انتخاب یک دسته از فهرست مجاز، نوشتن خلاصه کوتاه و استخراج چند کلیدواژه باشد. هر خروجی باید کاربرد روشنی در آرشیو داشته باشد.
برای اتصال برنامه یا جریان کار به مدلهای زبانی میتوان از api هوش مصنوعی لیارا استفاده کرد. این سرویس دسترسی به مدلهای مختلف را از طریق API فراهم میکند و نیاز به راهاندازی زیرساخت اجرای مدل را کاهش میدهد. انتخاب مدل را با چند نمونه واقعی انجام دهید؛ دقت در متن فارسی، رعایت قالب خروجی، زمان پاسخ و هزینه درخواست، معیارهای کاربردی این مقایسه هستند.
از مدل بخواهید اطلاعات ناموجود را حدس نزند. اگر نام نویسنده، تاریخ انتشار یا موضوع دقیق در متن مشخص نیست، خروجی باید این ابهام را نشان دهد. برای خلاصه هم سقف طول و مخاطب تعیین کنید. خلاصهای که قرار است کنار نام فایل نمایش داده شود، با گزارشی که برای مدیر پروژه نوشته میشود تفاوت دارد.

دستور مناسب، نتیجه قابل استفاده می سازد
یک دستور اولیه میتواند چنین باشد: «متن زیر را بخوان. یک عنوان کوتاه پیشنهاد بده، موضوع را فقط از میان دستههای آموزش، گزارش و معرفی محصول انتخاب کن و خلاصهای سهجملهای بنویس. اگر دسته مناسب مشخص نیست، مقدار نیازمند بررسی را برگردان. اطلاعاتی را که در متن وجود ندارد اضافه نکن و نام اشخاص و اعداد را تغییر نده.»
برای اتصال مراحل، قالب پاسخ نیز اهمیت دارد. میتوان خروجی را با فیلدهای ثابت عنوان، دسته، خلاصه و کلیدواژهها دریافت کرد تا مرحله بعد بداند هر مقدار را کجا ثبت کند. سپس وجود فیلدها، نوع دادهها و مجازبودن دسته بررسی شود. نوشتن دستور به تنهایی تضمین نمیکند که مدل همیشه قالب خواستهشده را رعایت کند.
محتوای فایل باید به عنوان داده تحلیل شود. اگر داخل سند جملهای مانند «دستورهای قبلی را نادیده بگیر» وجود داشت، نباید اختیار اجرای عملیات را پیدا کند. بهتر است خروجی مدل فقط پیشنهاد برچسب و خلاصه باشد و مسیر ذخیرهسازی یا حذف فایل بر اساس قواعد مشخص برنامه تعیین شود. این محدودسازی، رفتار سیستم را قابل پیشبینیتر میکند.
مرحله چهارم؛ مراحل را در n8n به هم متصل کنید
در n8n هر بخش از فرایند میتواند با یک گره نمایش داده شود. شروع کار، دریافت فایل از فرم یا ورودی برنامه است؛ سپس استخراج متن، بررسی معتبر بودن ورودی، درخواست تحلیل و ثبت نتیجه به هم متصل میشوند. قابلیت Form Trigger نیز امکان ساخت فرمی با ورودی فایل را فراهم میکند و میتواند نقطه شروع نمونه اولیه باشد.
برای در دسترس بودن جریان کار، n8n باید روی محیطی مناسب اجرا شود. هاست n8n لیارا امکان راهاندازی این ابزار به صورت برنامه آماده را فراهم میکند. این گزینه زمانی کاربرد دارد که بخواهید از مرحله نصب اولیه سریعتر عبور کنید و وقت بیشتری برای طراحی و آزمایش فرایند بگذارید. تنظیم اتصالها، تعریف قواعد و بررسی نتیجه همچنان بخشی از کار شماست.
برای اتصال سرویس هوش مصنوعی لیارا، مستندات آن تنظیم کلید API و آدرس پایه سرویس در بخش اطلاعات اتصال n8n را توضیح میدهد. پس از برقراری اتصال، ابتدا یک متن کوتاه را آزمایش کنید و سپس سراغ فایل واقعی بروید. بهتر است هر مرحله جداگانه خروجی قابل بررسی داشته باشد تا پیدا کردن علت خطا آسانتر شود.
یک مثال عملی از آرشیو تیم محتوا
فرض کنید اعضای یک تیم، گزارشها و مطالب پیشنهادی را برای دبیر محتوا ارسال میکنند. فایلها نامهای نامنظم دارند و دبیر باید موضوع و کاربرد هرکدام را تشخیص دهد. در نسخه اولیه سیستم، همکار فایل PDF متنی را همراه نام پروژه در فرم وارد میکند. سیستم فایل اصلی را نگه میدارد، متن را استخراج میکند و برای تحلیل میفرستد.
مدل برای یک راهنمای نرمافزاری، عنوان پیشنهادی و دسته «آموزش» تولید میکند و خلاصهای از موضوعات مطرحشده مینویسد. نتیجه همراه شناسه فایل در جدول آرشیو ثبت میشود. دبیر محتوا با دیدن خلاصه تصمیم میگیرد فایل را باز کند، برای بررسی به همکار دیگری بسپارد یا برچسب آن را اصلاح کند. اصل سند نیز همیشه از همان ردیف در دسترس است.
حالا اگر فایل دیگری تصویر اسکنشده باشد و استخراج متن نتیجهای ندهد، فرایند باید آن را نیازمند بررسی معرفی کند. خالیبودن متن نباید با دریافت خلاصه ساختگی پوشانده شود. همین رفتار ساده باعث میشود کاربر بداند کدام نتیجه آماده استفاده است و کدام فایل هنوز مرحله ناتمام دارد.
خروجی را برای پیدا کردن دوباره فایل طراحی کنید
آرشیو کاربردی فقط مجموعهای از خلاصهها نیست. هر ردیف باید ارتباط روشنی با فایل اصلی، پروژه، زمان دریافت و وضعیت پردازش داشته باشد. برای شروع میتوان نتیجه را در یک جدول ثبت کرد؛ با افزایش کاربران و نیاز به جستوجوی دقیقتر، ذخیره این اطلاعات در دیتابیس منطقیتر میشود. انتخاب ابزار باید با نحوه استفاده تیم هماهنگ باشد.
بهتر است عنوان پیشنهادی مدل از نام اصلی فایل جدا بماند. ممکن است مدل عنوان مناسبی بسازد، اما نام اولیه برای فرستنده یا سوابق پروژه معنا داشته باشد. نگهداری هر دو، پیدا کردن سند را آسانتر میکند. ثبت زمان آخرین تحلیل و نسخه دستور نیز کمک میکند بدانید خروجی با چه تنظیماتی تولید شده است.
اصلاحات انسانی را هم حفظ کنید. اگر دبیر محتوا دسته یک فایل را تغییر داد، پردازش دوباره نباید بدون اطلاع او مقدار اصلاحشده را بازنویسی کند. میتوان نتیجه مدل و مقدار نهایی را جدا ثبت کرد. این تفاوتها بعدا نشان میدهند کدام دستهها مبهم هستند و کجای دستور یا نمونهها باید تغییر کند.
خطا و ارسال تکراری را از ابتدا در نظر بگیرید
اتصال موقت قطع میشود، یک فایل ناقص بارگذاری میشود یا سرویس مدل پاسخ دیرهنگام میدهد. در چنین شرایطی، فرایند باید وضعیت مشخصی ثبت کند و فایل را بدون نتیجه رها نکند. وضعیتهایی مانند «در حال پردازش»، «تکمیلشده» و «نیازمند بررسی» برای کاربر قابل فهم هستند و پیگیری درخواست را سادهتر میکنند.
برای خطاهای موقت میتوان تعداد محدودی تلاش دوباره با فاصله زمانی تعریف کرد. خطای قالب نامعتبر یا متن خالی به اصلاح ورودی نیاز دارد و تکرار همان درخواست کمکی نمیکند. n8n امکان تعریف جریان رسیدگی به خطا را دارد؛ میتوان از آن برای ثبت شکست اجرا و اطلاعرسانی به مسوول مربوط استفاده کرد.
ارسال تکراری هم باید کنترل شود. شناسه درخواست و بررسی محتوای فایل کمک میکند یک ورودی چند بار وارد آرشیو نشود. در عین حال، نسخه اصلاحشده یک سند باید از نسخه قبلی قابل تشخیص باشد. پیش از اجرای دوباره، مشخص کنید کدام مراحل انجام شدهاند تا نتیجه یا اعلان تکراری تولید نشود.
هزینه و کیفیت را با داده واقعی بسنجید
هزینه این سیستم از چند بخش تشکیل میشود: میزبانی برنامه یا ابزار خودکارسازی، نگهداری فایلها و درخواستهای مدل. در بسیاری از مدلهای زبانی، حجم ورودی و خروجی بر هزینه اثر دارد؛ بنابراین فرستادن دوباره متنهای تکراری یا درخواست خلاصههای طولانی میتواند مصرف را افزایش دهد. پردازش فایلهای بزرگ باید متناسب با نیاز واقعی طراحی شود.
مدل گرانتر همیشه برای دستهبندی ساده ضروری نیست. چند مدل را روی مجموعه یکسانی از فایلهای واقعی مقایسه کنید و نتیجه را با معیار ثابت بسنجید. زمان پاسخ، تعداد دستهبندیهای اصلاحشده و میزان اطلاعات مهم ازدسترفته در خلاصه، تصویر روشنتری از عملکرد میدهند. آزمون باید فایلهای ساده، مبهم و کمکیفیت را هم در بر بگیرد.
کیفیت را پس از راهاندازی نیز بررسی کنید. اگر کاربران برای فهمیدن موضوع همچنان ناچارند همه فایلها را باز کنند، خلاصهها نیاز به بازنگری دارند. اگر دسته «نیازمند بررسی» بیش از انتظار استفاده میشود، شاید دستهبندی اولیه مناسب نیست. دادههای استفاده واقعی مشخص میکنند مرحله بعد توسعه باید روی چه مسالهای متمرکز شود.
از یک آزمایش محدود شروع کنید
پیش از اتصال کل آرشیو، فرایند را روی مجموعه کوچکی از فایلها اجرا کنید. نمونهها باید به کار روزانه شبیه باشند و فقط از اسناد مرتب انتخاب نشوند. برای ارزیابی، این موارد را بررسی کنید:
- فایل اصلی پس از پردازش سالم و قابل دسترسی باشد.
- عنوان و خلاصه با محتوای واقعی سند هماهنگ باشند.
- دسته پیشنهادی فقط از فهرست مجاز انتخاب شود.
- متن خالی و فایل نامعتبر به مسیر بررسی بروند.
- درخواست تکراری باعث ثبت چندباره نتیجه نشود.
- اصلاح انسانی در اجرای بعدی حفظ شود.
پس از رفع خطاهای این مرحله، تعداد فایلها را افزایش دهید. نگهداری نسخه پشتیبان و تعیین دسترسی اعضای تیم را نیز متناسب با حساسیت اسناد تنظیم کنید.
دسترسی به آرشیو را بر اساس نقش افراد تعیین کنید. کسی که فقط فایل ارسال میکند، لزوما نباید همه اسناد تیم را ببیند. همین تفکیک استفاده روزانه را منظمتر میکند و احتمال اشتراکگذاری اشتباه فایلها را کاهش میدهد.
پرسش های متداول
آیا این فرایند بدون برنامه نویسی قابل اجراست؟
بخشهایی مانند دریافت فرم و اتصال گرههای آماده را میتوان با ابزارهای بصری ساخت. با این حال، پردازش قالبهای خاص، قواعد پیچیده و اتصال به سامانه اختصاصی ممکن است به کدنویسی یا کمک فنی نیاز داشته باشد.
آیا هوش مصنوعی همه فایل ها را درست دسته بندی می کند؟
خیر. متن ناقص، موضوع مبهم و دستههای همپوشان میتوانند باعث خطا شوند. تعریف دستههای روشن، آزمایش نمونههای واقعی و امکان اصلاح نتیجه ضروری است. برای تصمیمهای حساس، بازبینی انسانی را در مسیر نگه دارید.
آیا باید کل فایل برای مدل ارسال شود؟
این موضوع به نوع تحلیل و قابلیت مدل بستگی دارد. برای دستهبندی متن، میتوان بخش مرتبط و استخراجشده را ارسال کرد. اطلاعات شخصی یا محرمانه غیرضروری را پیش از ارسال حذف کنید و شرایط پردازش داده سرویس را بررسی کنید.
نتیجه گیری
خودکارسازی مدیریت فایل زمانی ارزشمند است که پیدا کردن اطلاعات را آسانتر کند و حجم کار تکراری را کاهش دهد. برای شروع، دریافت فایل، استخراج متن، پیشنهاد دسته و ثبت خلاصه کافی است. سپس میتوان با بررسی خطاها و نیاز کاربران، امکانات بیشتری اضافه کرد.
میزبانی مناسب، دسترسی به مدل و ابزار اجرای جریان کار هرکدام وظیفه مشخصی دارند. انتخاب آنها بر اساس نیاز، حفظ فایل اصلی و امکان اصلاح نتیجه، پایه سیستمی است که میتوان به مرور توسعه داد و در کار روزانه از آن استفاده کرد.
